
 Bullish71 auf wikifolio, Stand 26. September 202626.09.2026
Seit dem 11. November 2019 bin ich auf wikifolio als Bullish71. Das Profil mit allen drei wikifolios: wikifolio.com/de/at/p/bullish71.
Die Zahlen sind der Stand vom 26. September 2026. Eine Bestandsaufnahme, keine Prognose und keine Anlageempfehlung.
Mit Aktien habe ich mich erstmals 1999 befasst, weil der damalige Arbeitgeber Aktien und Aktienoptionen als Teil des Gehalts angeboten hat. Danach kamen Fonds, Dachfonds, Aktien und Zertifikate. Beruflich sitze ich in der IT, bei Themen, die Bestehendes verschieben. Zuerst entscheide ich, worin ich überhaupt investieren würde. Den Zeitpunkt prüfe ich danach.
Hier liegen Aktien, bei denen ich Innovationspotenzial sehe. Neue Technologie, Software, Internethandel, und Firmen, die von der Energiewende profitieren könnten. Ich halte lieber, als bei jedem Kursverlust zu verkaufen. Technisch schaue ich meist auf zwei Dinge: einen positiven MACD, und einen Kurs über dem Schnitt der letzten 90 Tage. Dazu der Blick auf Politik, Branche und Lieferketten. In der Regel mindestens zehn Titel. Ein einzelner soll nicht über rund die Hälfte hinaus, ETFs zur Streuung ebenfalls nicht.
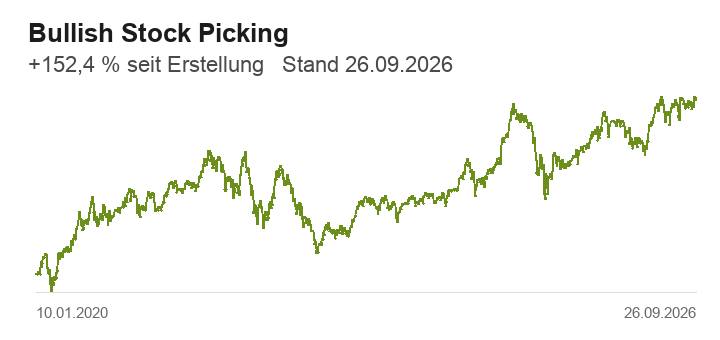
Bullish Stock Picking (WFXBULLISH), ISIN DE000LS9TKG1, Erstemission 14. Juni 2022.
Ein Dach aus anderen wikifolio-Zertifikaten, ohne Hebel. Ich suche Portfolios, die regelmäßig betreut werden und mindestens fünf Aktien halten. Breit gestreut, eher defensiv, mit langem Atem. Auf dem Profil führt wikifolio dieses als Top-wikifolio. Das Zertifikat ist in Deutschland zum Vertrieb zugelassen.
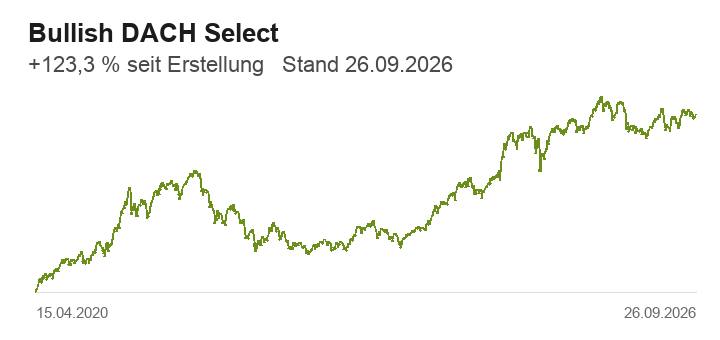
Bullish DACH Select (WFBULLDACH), ISIN DE000LS9RXP9, Erstemission 27. Juli 2021.
Eine Liste von ETFs, von denen ich mir eine positive Entwicklung erwarte. Keine Chartanalyse. Die Ideen kommen aus der Berichterstattung, auch aus Social Media. Ein Zertifikat gibt es dazu noch nicht, kaufen kann man es derzeit nicht.
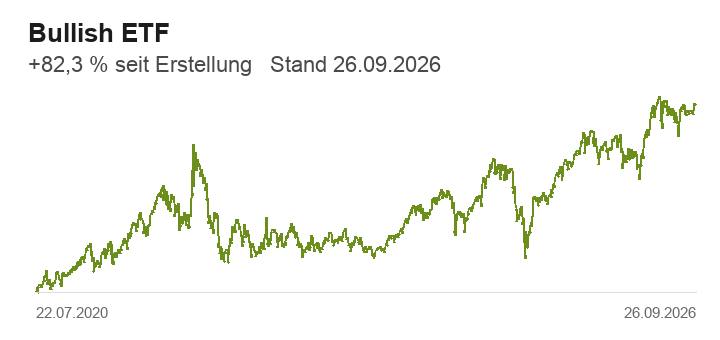
Bullish ETF (WFXBULLETF).
Über alle drei weist wikifolio die Auszeichnung "Regelmäßige Aktivität" aus. In den Risikoklassen 1 bis 5 steht die Handelserfahrung jeweils auf drei oder mehr Jahre.
go-e Gemini in der neuen everHome Cloud26.09.2026Die neue everHome-Oberfläche liegt unter everhome.cloud/app. Eine ältere Anleitung richtet das Überschussladen über das Intelligenz-Symbol im Reiter Strom ein. In der neuen Cloud ist das die Aufgabe in der Energieplanung, nicht mehr dieser Weg.
Gebraucht wird eine OCPP-fähige Wallbox, hier ein go-e Charger Gemini, und ein Stromzähler, den everHome schon ausliest. Ohne den Zähler kennt die Cloud den Überschuss nicht.
Am Zähler der Netz Niederösterreich hängt ein everHome EcoTracker P1. Er steckt am P1-Anschluss des Smartmeters, mit dem beiliegenden RJ12-Kabel. Einen Elektriker braucht es dafür nicht. Die Installation ist einfach, und danach liegen die Zählerdaten in der everHome-Cloud.
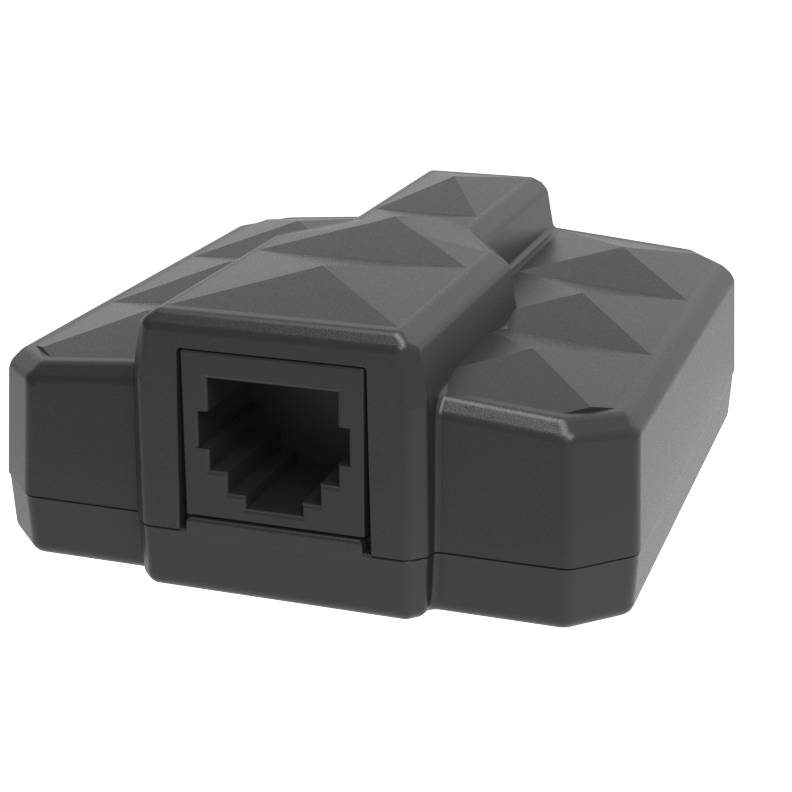
Im Shop kostet der EcoTracker P1 derzeit 99 Euro: everhome.cloud/de/ecotracker-p1. Die everHome-App ist kostenlos, eine monatliche Gebühr für den Dienst nennt der Hersteller nicht.
Der P1-Anschluss muss beim Netzbetreiber freigeschaltet sein. Das Kennwort für den Smartmeter hat die Netz Niederösterreich innerhalb von zwei Werktagen geschickt, in zwei Teilen: das Kennwort in einem verschlüsselten ZIP, das Kennwort für das ZIP per SMS.
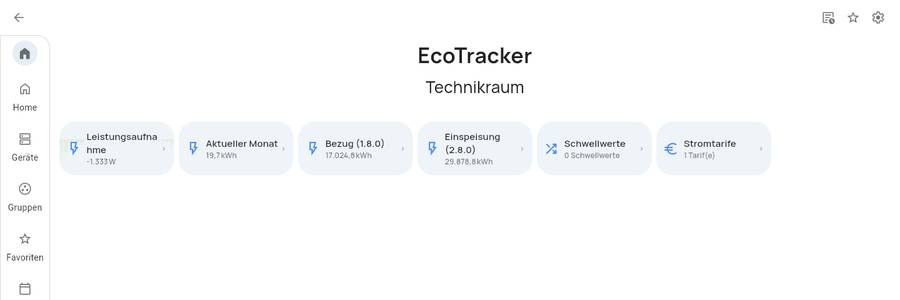
In der Cloud zeigt der EcoTracker die Leistungsaufnahme und die Zählerstände, die der P1-Anschluss liefert: Bezug 1.8.0 und Einspeisung 2.8.0.
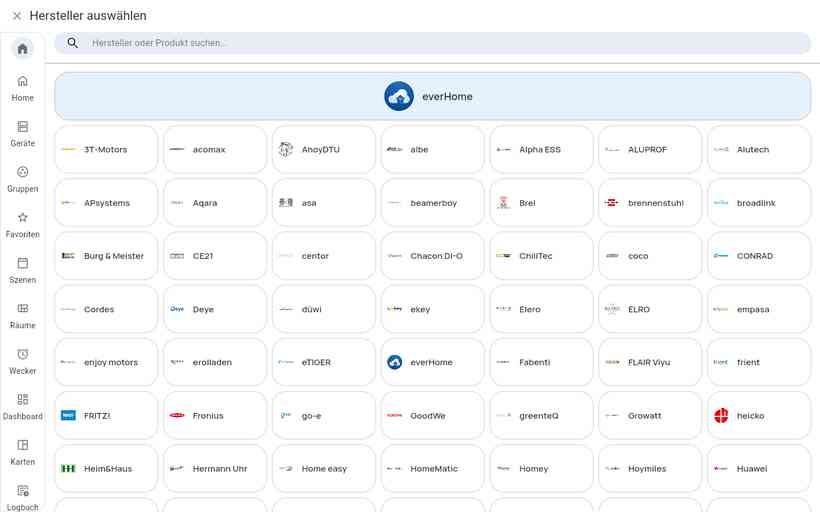
Unter Geräte auf Hinzufügen tippen und den Hersteller go-e wählen.
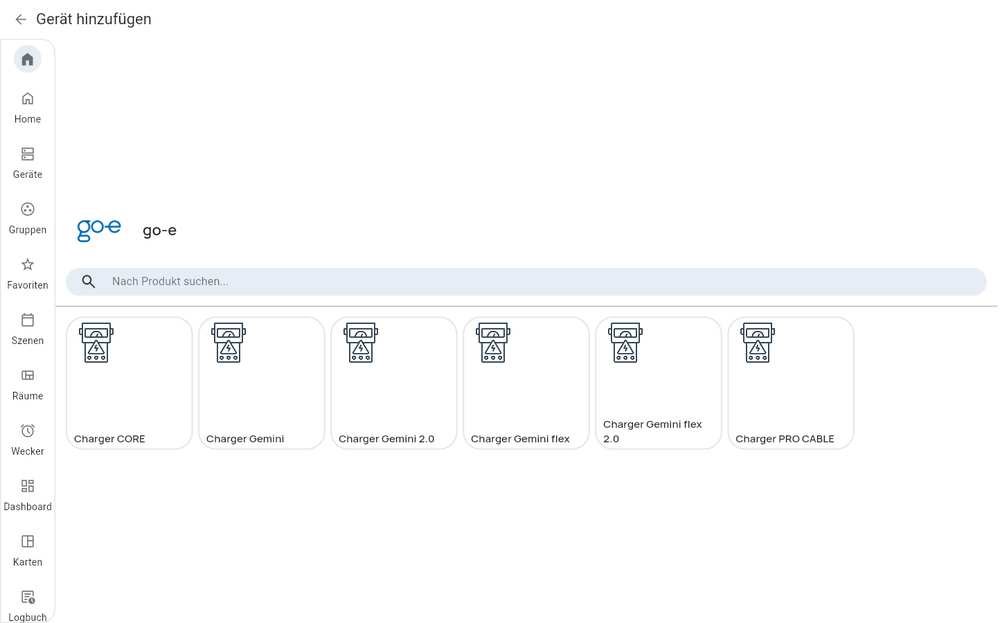
Als Produkt den Charger Gemini wählen. everHome zeigt danach eine OCPP-Adresse. Die gehört in die Wallbox, nicht in ein öffentliches Bild.
In der go-e App: Einstellungen, Verbindung, OCPP. Die angezeigte Adresse eintragen. Die Option Seriennummer an URL anhängen bleibt eingeschaltet. Damit meldet sich die Wallbox bei everHome.
Das Gerät ist danach sichtbar. Es lädt damit noch nicht mit dem PV-Überschuss.
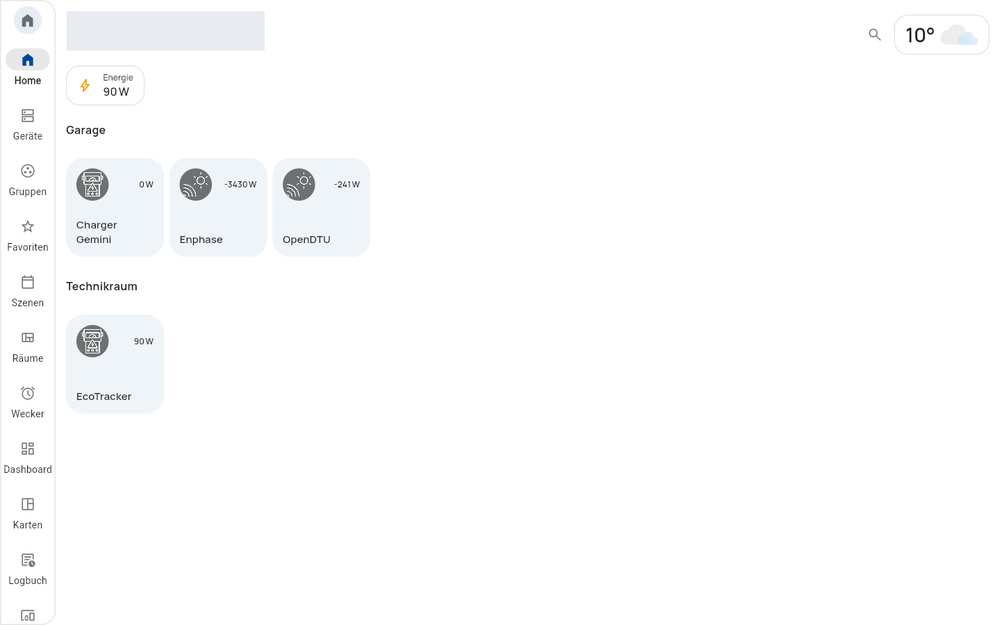
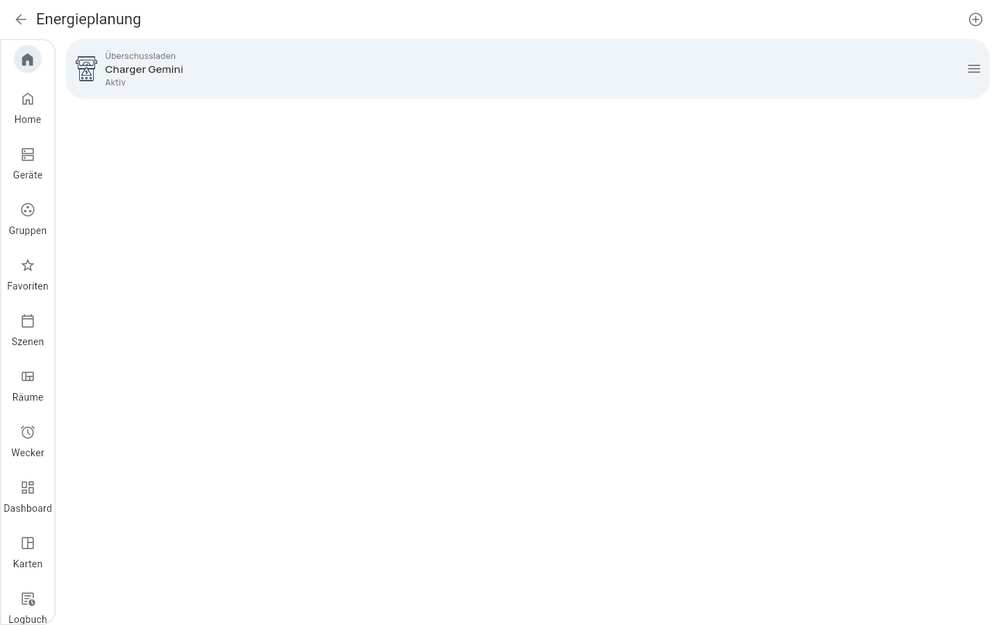
Das Verhalten schaltet erst die Energieplanung: everhome.cloud/app/energy/management. Dort eine Aufgabe anlegen, die Wallbox auswählen und als Geräteverhalten Überschussladen setzen. Die Aufgabe muss aktiv sein.
Solange diese Aufgabe fehlt, bleibt der Gemini nur angebunden. everHome startet das Laden mit Überschuss nicht von selbst, nur weil das Gerät in der Liste steht.
Auf der Geräteseite zeigt die Kachel Energieplanung danach auf Überschussladen.
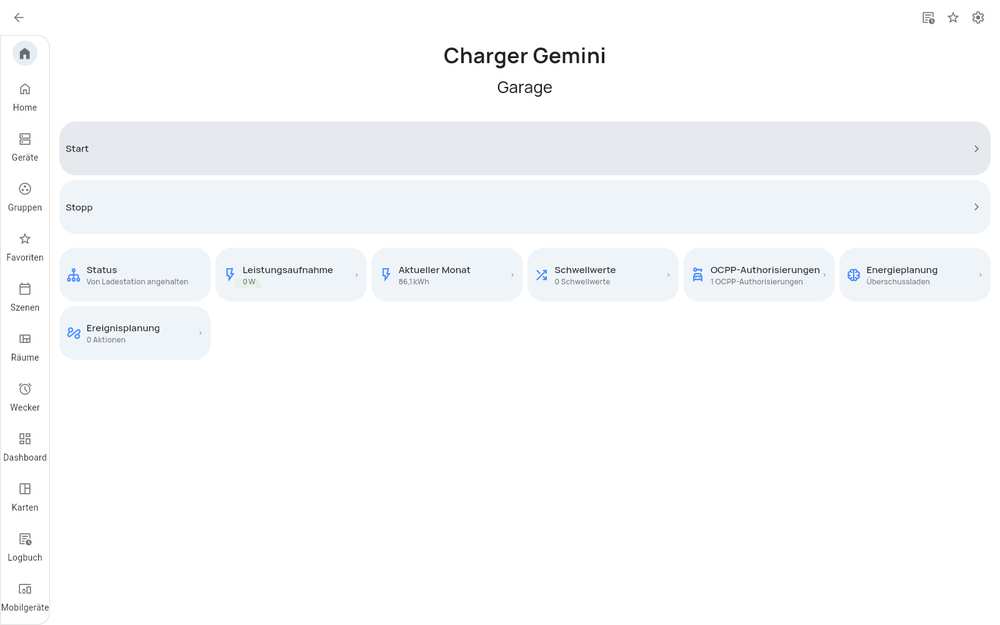
In der Energieplanung steht die Aufgabe mit dem Namen der Wallbox und dem Status Aktiv.
Öffnet man die Aufgabe, heißt das Geräteverhalten Überschussladen und der Status ist Aktiv. Erst das ist die Freigabe.
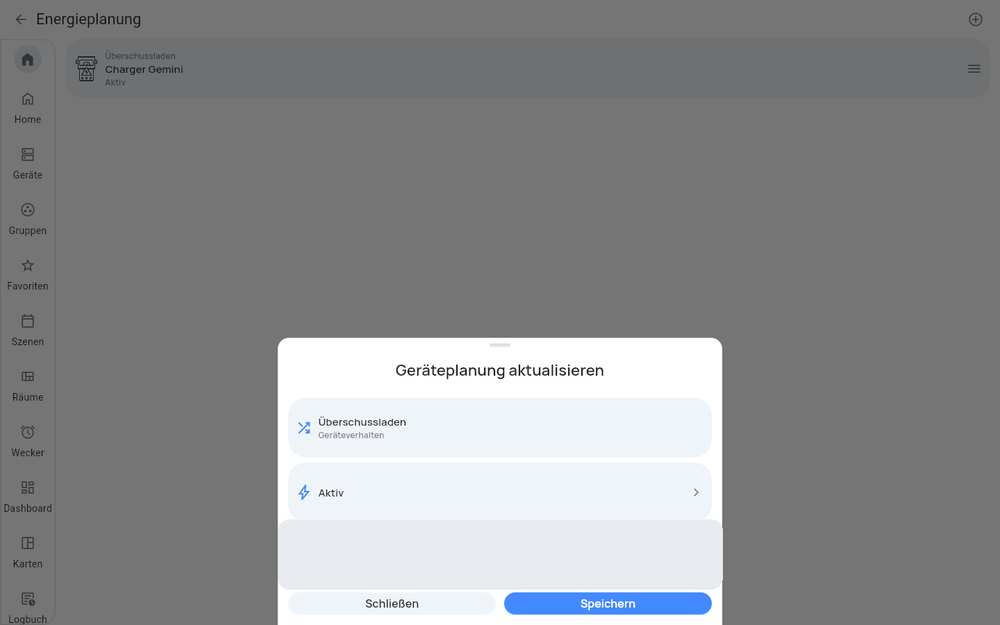
Ist der Gemini schon einer Aufgabe zugeordnet, bietet das Plus kein weiteres freies Gerät an. Das Verhalten sieht man dann an der bestehenden Aufgabe, nicht in einem leeren Auswahldialog.
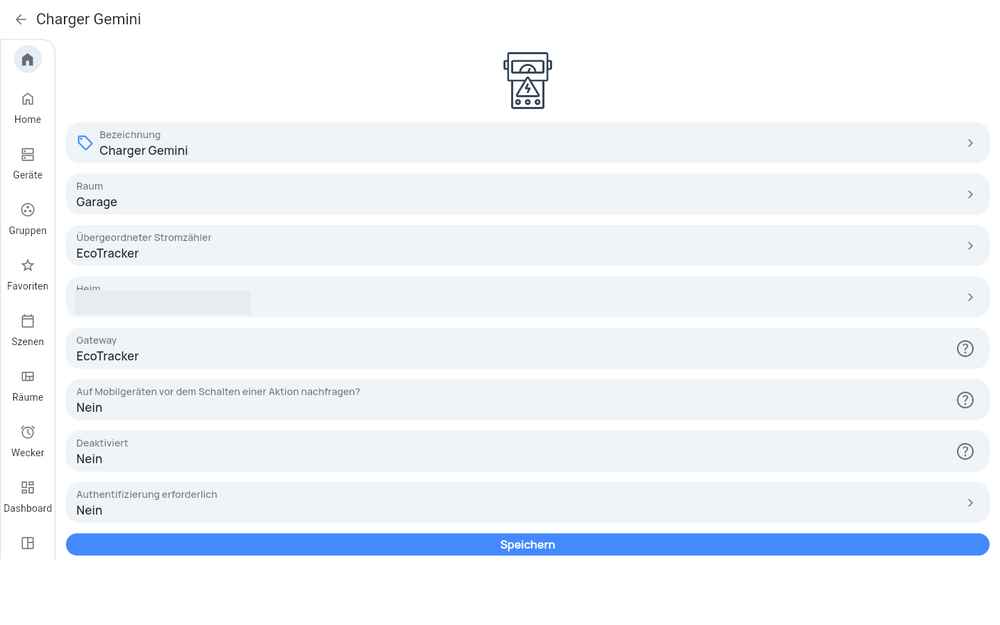
In den Geräteeinstellungen hängen übergeordneter Stromzähler und Gateway am EcoTracker. Die OCPP-Adresse steht auf derselben Seite unter dem Speichern-Knopf. Sie ist ein Zugang zur Wallbox und bleibt aus dem Bild.
Ein OCPP-Slot, mehrere Backends: warum ich ocpp-fanout gebaut habe10.09.2026Die meisten Wallboxen haben genau einen OCPP-WebSocket. Lokal soll trotzdem der eigene Regler Strom und Phasen setzen — MQTT, HTTP, Modbus, nicht das Backend in der Cloud. Gleichzeitig sollen Dienste wie ein Enphase IQ Energy Router, EverHome oder Monta live mitlesen. Wer den einen Slot an ein Vendor-CSMS hängt, gibt die Steuerung oft stillschweigend ab.
Dieser Beitrag beschreibt die Problemstellung und wie ein eigenes Open-Source-Projekt sie löst: ocpp-fanout.
OCPP 1.6-J ist der Kanal, den die Wallbox für die Backend-Kommunikation
hat. Ein Slot heißt: eine WebSocket-URL. Alles, was die Box als CSMS
ansieht, darf CallResults liefern — und in der Praxis auch Befehle
schicken: SetChargingProfile, RemoteStart,
ChangeConfiguration.
Ich will drei Dinge gleichzeitig:
Das widerspricht sich, sobald das „Monitor“-Backend ein volles CSMS ist.
Viele Monitor-Backends sind keine reinen Zuschauer. Sie schicken Calls zur Wallbox. Ohne CallResult gilt die Box in der App als tot. Mit unkontrollierter Weiterleitung übernimmt das Backend die Ampere. Beides ist falsch, wenn der lokale Regler die Ladeleistung setzt.
Konkret:
GetConfiguration und
TriggerMessage(StatusNotification). Ohne lokale Antwort bleibt
Enlighten leer, obwohl der WebSocket steht. Leitet man
SetChargingProfile durch, springen die Ampere — der Router
soll im Monitor-Modus zuschauen, nicht laden.ocpp1.6. Ein Standard-OCPP-Proxy bricht mit
Server sent no subprotocol ab.RemoteStart und stimmige StartTransaction /
transactionId. Ein Dummy, der andere IDs vergibt, füllt das
Ladeprotokoll nicht.Die Wallbox kann das nicht gleichzeitig erfüllen. Es gibt nur einen Slot.
joulo-ocpp-proxy macht genau den Split 1→N: eine eingehende Verbindung, ein Primary mit voller Kontrolle, beliebig viele Secondaries als Spiegel. Secondary zur Wallbox wird verworfen. Das ist gewollt: ein Secondary darf die Box nicht fernsteuern.
| Richtung | Primary | Secondary |
|---|---|---|
| Wallbox → CSMS | weitergeleitet | gespiegelt |
| CSMS → Wallbox | weitergeleitet | verworfen |
Genau dort kippt der Plan. Die Monitor-Backends schicken trotzdem Calls. Joulo wirft sie weg und antwortet nicht an ihrer Stelle. Es gibt kein CallResult, die Vendor-App bleibt ohne Live-Status (historische kWh können trotzdem erscheinen).

Joulo hat außerdem nur einen Schalter
SECONDARY_CSMS_APPEND_CHARGE_POINT_ID. Enphase will die
Charge-Point-ID in der URL, EverHome und Monta haben die Identität oft
schon im Pfad. Ein Flag für alle Secondaries passt nicht.
Ich habe Joulo nicht geforkt. Der Proxy bleibt das Image von
ghcr.io. Davor und dahinter sitzt eigener Code: ein Dummy-Primary,
kleine Antwort-Shims und eine Web-UI.

Drei Ergänzungen schließen die Lücken:
[3, id, payload]), sonst gilt sie
als offline. Der Dummy tut das. Eigene Steuerung sendet er nicht.
POST /inject ist der einzige Weg, über Joulo einen CSMS-Call
zur Box zu schicken — und der Endpunkt hängt nur am Compose-Netz,
nicht am Host.Ein Image, drei Shim-Dienste (SHIM_NAME /
SHIM_PORT): Enphase, EverHome, Monta.
| Ziel | Wer |
|---|---|
| Laden, Phasen, Start/Stop | lokaler Regler (MQTT / Enphase HTTP, nicht OCPP) |
| Box bleibt OCPP-online | Dummy-CSMS als Primary |
| Enlighten / EverHome / Monta sehen Live-Daten | Secondaries über Shims |
| Ausgewählte CSMS-Befehle dürfen zur Box | Setup-Allowlist → Dummy-Inject durch Joulo |
| Alles andere bleibt von der Box fern | Shim antwortet lokal, UI zeigt dropped |
Die Wallbox zeigt auf einen WebSocket:
ws://<host>:9100/<chargePointId>.
GetConfiguration und TriggerMessage. Wer Live-Status
in Enlighten will, erlaubt in Setup
TriggerMessage:StatusNotification.
SetChargingProfile bleibt von der Allowlist fern, solange der
Router nur beobachten soll.ocpp1.6, sonst kommt die Verbindung nicht zustande.RemoteStart
(nur wenn allowlisted), transactionId auf MeterValues /
StopTransaction auf die von Monta vergebene ID mappen,
StartTransaction nachspielen, wenn schon eine Session offen
ist.Spec-konforme lokale Antworten gibt es auch für RFID-Liste und Clear
Profile (Accepted), ohne die Box zu beschreiben.
Ohne UI rät man, welcher Call wo landet. Die Live-Ansicht zeigt den Paketfluss: Wallbox, Proxy, Dummy, Shims, Backends — und den Korb dropped für alles, was der Secondary nicht zur Box durchreicht.

Beim Laden zeigt die EV-Karte Phasen, Ampere je Phase und kW aus den
MeterValues (Current.Import L1/L2/L3 und
Power.Active.Import).
Zwei Compose-Dateien: voller Stack mit Healthchecks und rotierten Logs, oder
eine einfache Variante ohne Healthchecks, in der Charge-Point-ID, Backend-URLs
und Allowlist nur in der Setup-UI stehen. Compose baut Dummy, Shim und UI
lokal; Joulo kommt von ghcr.io.
git clone https://github.com/cbrandlehner/ocpp-fanout.git
cd ocpp-fanout
git checkout v1.0.0
cp .env.example .env
docker compose up -d --build
Web-UI: http://<host>:8088/. Den OCPP-WebSocket
(Standardport 9100) und die Setup-UI nicht ins öffentliche Internet
legen. Strom und Phasen gehören zum lokalen Regler, nicht zum Secondary,
es sei denn, ein Befehl steht bewusst auf der Allowlist.
Quellcode und Release 1.0: github.com/cbrandlehner/ocpp-fanout, Tag v1.0.0. Deutsche Bedienung: docs/ANLEITUNG.md.
ocpp-fanout ist ein unabhängiges Open-Source-Projekt ohne Herstellersupport. Es steht in keiner Verbindung zu go-e, Enphase, everHome, Monta, Joulo, Tesla oder anderen Anbietern, deren Produkte es ansprechen kann, und wird von diesen weder unterstützt noch empfohlen. Nutzung auf eigene Gefahr. Produktnamen dienen nur der Beschreibung der Anbindung.
Ein OCPP-Slot kann nicht gleichzeitig lokaler Regler und drei Vendor-CSMS sein. Joulo teilt 1→N und hält Secondary-Steuerung von der Box fern — das allein lässt Enlighten, EverHome und Monta aber tot aussehen, weil ihnen die CallResults fehlen. ocpp-fanout ergänzt Dummy, Shims und UI: die Secondaries bleiben am Leben, Antworten sind lokal, und nur eine explizite Allowlist darf einen Befehl zur Wallbox injizieren. Die Steuerung bleibt, wo sie hingehört.
iLO 4 hinter Traefik: Redfish-POST liefert HTTP 50208.09.2026HP iLO 4 spricht ein TLS, das moderne Browser und aktuelle OpenSSL-Bibliotheken ablehnen. Ein Reverse Proxy mit gültigem Zertifikat davor ist der pragmatische Weg: GET /redfish/v1 funktioniert, aber POST auf die Reset-Action kommt mit HTTP 502 vom Proxy zurück.
Zwei unabhängige Ursachen, beide typisch für iLO 4 hinter Traefik 3.
iLO 4 (ProLiant Gen8) bringt ein BMC-Zertifikat und Cipher-Suiten mit, die heutige Clients nicht mehr akzeptieren. Traefik terminiert TLS nach außen — zum Beispiel mit Let’s Encrypt — und spricht nach innen HTTPS gegen iLO, mit insecureSkipVerify.
Lesezugriffe laufen oft ohne weiteres durch. Schreibende Redfish-Calls, insbesondere Power-On über ComputerSystem.Reset, nicht.
Traefik 3 spricht Backends über HTTPS standardmäßig mit HTTP/2 und hält TLS-Verbindungen offen. iLO 4 kommt damit nicht zurecht. Der Proxy sieht einen kaputten Upstream und antwortet 502 Bad Gateway.
Fix am Service, mit eigenem serversTransport:
http:
  serversTransports:
    iloTransport:
      insecureSkipVerify: true
      disableHTTP2: true
      forwardingTimeouts:
        idleConnTimeout: 1s

  services:
    ilo:
      loadBalancer:
        serversTransport: iloTransport
        passHostHeader: false
        servers:
          - url: "https://ilo.example.internal"
disableHTTP2: true — HTTP/1.1 zum BMCidleConnTimeout: 1s — keine langlebigen Keep-Alive-VerbindungeninsecureSkipVerify: true — das BMC-eigene ZertifikatpassHostHeader: false — Host-Header des Backends, nicht des öffentlichen NamensRedfish-Actions bei iLO 4 erwarten den trailing slash:
POST /redfish/v1/Systems/1/Actions/ComputerSystem.Reset/
Ohne Slash antwortet iLO mit 308 und einer Location auf die interne BMC-Adresse, nicht auf den öffentlichen Proxy-Namen. Traefik folgt dem Redirect oder scheitert daran — in beiden Fällen oft wieder 502.
Clients müssen die Action-URL mit Slash posten:
POST /redfish/v1/Systems/1/Actions/ComputerSystem.Reset/
Content-Type: application/json

{"ResetType":"On"}Wenn GET /redfish/v1/ durch den Proxy HTTP 200 liefert, das BMC also erreichbar ist, POST aber 502:
serversTransport abschaltenWenn auch GET 502 liefert, ist das BMC oder der Weg dorthin down — das ist ein anderes Problem.
iLO 4 hinter einem modernen Reverse Proxy ist machbar, aber nicht „einfach durchreichen“. Traefik 3 und iLO 4 vertragen sich bei POST nicht von selbst: HTTP/2 und TLS-Keep-Alive müssen raus, und Redfish-Actions brauchen den abschließenden Slash. Danach funktioniert Power-On über Redfish zuverlässig.
Microsoft 365 archivieren, ohne ein WORM-Produkt zu kaufen04.09.2026Eine liquidierte österreichische GmbH hinterlässt Mail, OneDrive und SharePoint in Microsoft 365. Die Aufbewahrung soll zehn Jahre halten: lesbar, nachvollziehbar, möglichst unveränderlich. Es gibt kein Budget für ein zertifiziertes Archivprodukt, und der Tenant läuft nicht ewig weiter.
Dieser Beitrag beschreibt Ausgangslage, Anforderungen und die Umsetzung eines selbstgebauten Verfahrens — inklusive der Stelle, an der die Microsoft-Konsole und der Export scheinbar nicht zusammenpassen.
Nach der Liquidation bleiben die Daten in Microsoft 365, bis jemand sie abzieht. Typische Versuchung: ZIP vom OneDrive, PST aus Outlook, SharePoint-Bibliothek „herunterladen“. Das ist weder vollständig noch nachvollziehbar, und in zehn Jahren will niemand raten, welche ZIP-Datei die richtige war.
Rechtlich relevant sind in Österreich unter anderem Nachvollziehbarkeit, Lesbarkeit und Unveränderbarkeit (BAO, UGB). Das ersetzt kein zertifiziertes DMS und keine Freigabe durch den Steuerberater. Frist und Umfang muss der Steuerberater bestätigen. Die Projektvorgabe hier war bewusst 10 Jahre, nicht die oft zitierte 7-Jahres-Untergrenze.
Dieses Verfahren ist nicht GoBD-zertifiziert, nicht BAO-zertifiziert und kein WORM-Produkt. Was Technik und Betrieb leisten, steht unten; Lücken werden nicht verschwiegen.
.eml).Die Pipeline ist klein und bewusst zweigeteilt.
Steuerung vs. Worker. Ein Laptop orchestriert (Erreichbarkeit, Provisioning, Sync). Der Export lief auf einer Wegwerf-VM. Nach dem Upload in den Tresor ist die VM weg; lokal bleibt nichts, was man in zehn Jahren noch booten müsste.
Microsoft Graph, nur lesen. Berechtigungen: Mail.Read, Files.Read.All, Sites.Read.All, User.Read. Der Archiv-Admin liegt außerhalb der Firmendomäne (*.onmicrosoft.com), nicht im Benutzerstamm der GmbH. App-Registrierung plus Admin-Consent; Secrets nie ins Git.
Originalbytes, Hash, Resume. Dateien und Mails landen als Content-Addressed Store plus Pfadkopie. Daneben SHA-256-Sidecars und Manifeste. Eine SQLite-Job-DB erlaubt Resume nach Abbruch. Das Audit-Log enthält keine Tokens und keine Mail-Bodies.
Katalog, nicht Suche im Bucket. Jeder Lauf schreibt Excel (Katalog.xlsx): ursprünglicher Pfad, Dateiname, Betreff, SHA-256, S3-Schlüssel, Fehler, Laufinfo, eine Blatt-Anleitung. Dieselbe Datei liegt zusätzlich unter einem festen Schlüssel im Bucket. Glacier/S3 bleibt der Tresor.
S3 Object Lock. Bucket in eu-central-1, Versioning an, Object Lock Compliance, Default-Retention 10 Jahre. Compliance lässt sich nicht umgehen — auch nicht als Root. IAM für den Empfänger: Lesen und PutObject für Nachträge (etwa eine Abschlussbilanz), kein Delete.
Übergabe. Paket ohne Secrets: Katalog, kleines CLI, Anleitung. Der Empfänger richtet Access Key und Secret einmal lokal ein (nicht per Chat). Alltag: im Katalog filtern, per Schlüssel holen, SHA-256 prüfen. Nachträge denselben Weg, wieder mit Hash-Zeile im Katalog.
Die Microsoft-Konsole und der Export messen nicht dieselbe Menge. Eine Abweichung heißt nicht automatisch „es fehlen Dateien“.
| Was man sieht | Was es oft ist | Was der Export nimmt |
|---|---|---|
| Speicher in GB (Berichte, aktive Sites) | Site plus OneDrive, inklusive Versionen, Papierkorb, Metadaten | nur aktuelle Dateibytes |
| Websiteinhalte / Kachel „Dokumente“ | Dateien und Ordner, oft Cache | nur Graph-file |
| Nutzungsbericht „Dateien“ | inkl. System/Papierkorb, zeitversetzt | Katalogzeilen |
In diesem Lauf: rund 13 000 Mails als .eml, rund 3 400 aktuelle SharePoint-Dateien (etwa 11 GB Inhalt). Die Konsole zeigte in der Größenordnung 65 GB. Stichprobe: Office-Dateien mit mehreren Versionen (eine Präsentation 27 MB aktuell, über alle Versionen ein Vielfaches). Große Videos oft nur eine Version. Versionen erklären den Großteil der GB-Lücke; sie sind in dieser Version bewusst nicht mitarchiviert.
Websiteinhalte zählte Dateien plus Ordner und lag dazwischen — unbrauchbar als Soll-Zahl. Persönliches OneDrive war klein; der Speicher saß auf der Team-Site.
Regel: Soll-Zahl für „haben wir alle aktuellen Dateien?“ ist Graph-file bzw. Katalogzeilen, nicht Konsole-GB und nicht Websiteinhalte. Konsole-GB gegen Graph-Quota; Katalog-SHA-256 gegen lokale Blobs.
/content der aktuellen Version)Ein Dateitransport (rclone o. ä.) ersetzt kein Archiv-Zertifikat. Metadaten und Berechtigungen hängen vom Backend ab; die Vollständigkeit ist nicht zugesichert. Fehler und Teilmengen müssen über Job-DB und Verify sichtbar bleiben.
Für eine liquidierte Firma mit klarer Frist reicht ein selbstgebautes, dokumentiertes Verfahren: Originalbytes, Hash, Katalog, Object Lock, ehrliche Lücken. Es ersetzt kein zertifiziertes DMS und keinen Steuerberater. Wer die Microsoft-Konsole als Soll-Zahl nimmt, sucht Dateien, die der Export nie holen sollte — vor allem alte Versionen.
Smarte Pumpenpflege mit dem Shelly – Stillstand vermeiden und Heizungssteuerung respektieren01.10.2025Viele Heizungsanlagen besitzen Umwälzpumpen, die außerhalb der Heizsaison oft über Monate hinweg stillstehen. Dieses lange Stillstehen kann zum Problem werden: Rotoren verkleben, Lager setzen sich fest und die Pumpe läuft bei Beginn der Heizsaison nicht mehr zuverlässig an.
Im Sommer oder in Übergangszeiten bleibt die Pumpe meist komplett ausgeschaltet. Sobald die Heizperiode wieder beginnt, soll sie zuverlässig anlaufen – tut sie das nicht, drohen kalte Räume und im schlimmsten Fall ein kostspieliger Pumpentausch.
Mit einem Shelly-Relais lässt sich ein einfacher Schutzmechanismus einbauen: Einmal pro Woche wird die Pumpe für ein paar Minuten eingeschaltet. Dadurch bleibt sie beweglich und lässt sich im Herbst wieder problemlos starten.
„Prävention ist günstiger als Reparatur – ein paar Minuten Pumpenlauf pro Woche können viel Ärger vermeiden.“
Damit es keine Konflikte mit der Heizungssteuerung gibt, sollte das Skript am Ende den ursprünglichen Zustand wiederherstellen. Läuft die Pumpe, bleibt sie an – war sie ausgeschaltet, wird sie auch wieder ausgeschaltet.
Das folgende Skript lässt sich direkt im Shelly eintragen:
// Shelly Script: Pumpe wöchentlich kurz einschalten
// Funktion, die nach 60s prüft ob der Eingang aktiv ist
function checkInputAndSwitch() {
  let input = Shelly.getComponentStatus("input:0");
  if (input.state) {
    print("Eingang ist aktiv – Pumpe bleibt EIN");
  } else {
    Shelly.call("Switch.Set", { id: 0, on: false });
    print("Eingang ist aus – Pumpe wird ausgeschaltet");
  }
}

// Schedule erstellen: Montag 09:00 Uhr
Shelly.call("Schedule.Create", {
  enable: true,
  timespec: "0 9 * * 1",  // Montag 09:00
  calls: [
    {
      method: "Switch.Set",
      params: { id: 0, on: true }
    },
    {
      // hier wird das Script selbst gestartet,
      // welches dann den Timer setzt
      method: "Script.Start",
      params: { id: Shelly.getCurrentScriptId() }
    }
  ]
});

// Event-Handler: wenn das Script gestartet wird (durch Schedule)
Shelly.addEventHandler(function (ev, data) {
  if (ev === "script_started") {
    // Timer: 60 Sekunden warten, dann Funktion aufrufen
    Timer.set(60 * 1000, false, checkInputAndSwitch);
  }
});
Mit wenig Aufwand lässt sich so die Lebensdauer der Pumpe verlängern. Die Kombination aus Shelly-Automatisierung und Timer bietet eine einfache, aber wirkungsvolle Lösung, um teuren Defekten vorzubeugen.
CrowdSec auf der E.F.A. — Erfahrungen, Zertifizierungen und eigene Szenarien29.09.2025In diesem Beitrag beschreibe ich kurz, was CrowdSec ist, welche Zertifizierungen ich abgeschlossen habe, wie ich CrowdSec auf der E.F.A. (Email Filter Appliance) integriert habe, welche Filter out-of-the-box funktionieren — und wie ich fehlende Unterstützung (z. B. für MailScanner) durch eigene Parser und Szenarios ergänze.
CrowdSec ist eine Open-Source-Plattform zur Erkennung und Abwehr von bösartigen Aktivitäten anhand von Log-Analysen. Der Kern besteht aus einem lokalen Agenten, der Logs einliest, Ereignisse korreliert und auf Basis von Signalen (sogenannte scenarios) Entscheidungen trifft. Erkenntnisse können lokal genutzt oder an die Community-Sharing-Plattform gesendet werden, um die Reputationen von IPs zu teilen.
Ich habe mehrere Zertifizierungen rund um CrowdSec durchlaufen, die mir geholfen haben:
Die Zertifizierungen haben vor allem im Bereich Log-Modelling und Scenario-Design meine Fähigkeit verbessert, aus oft heterogenen Mail-Logs zuverlässige Signale zu extrahieren.
Auf meiner E.F.A. läuft ein Satz klassischer Mail-Dienste (sshd für Remote-Management, postfix für SMTP, SpamAssassin und MailScanner für Mailprocessing). CrowdSec lässt sich gut auf der E.F.A. betreiben und bringt sofort Mehrwert:
sshd, postfix, webserver-logs, und mehr.MailScanner gibt es jedoch zum Zeitpunkt meiner Integration kein fertiges Parser-/Scenario-Paket.MailScanner ist in vielen Installationen ein wichtiger Teil der Mailpipeline. Da seine Logstruktur teils proprietär oder stark konfigurierbar ist, existieren nicht immer allgemeingültige Parser. Außerdem sind Mail-Logs oft sehr rauschbehaftet — viele Events sind normal und müssen gefiltert werden.
Ich habe deshalb eigene parsers (für die Log-Formate) und scenarios (für die Erkennung von Angriffs-/Missbrauchsmustern) geschrieben. Hier die konkreten Beispiele:
name: cbrandlehner/mailscanner-spam-blacklist
description: Parse MailScanner spam logs for blacklisted senders
onsuccess: next_stage
filter: "evt.Parsed.program == 'MailScanner'"
grok:
  pattern: 'Message %{NOTSPACE:message_id} from %{IP:source_ip} \(%{EMAILADDRESS:from_email}\) to %{NOTSPACE:to_domain} is spam \(%{WORD:spam_reason}\)'
  apply_on: message
statics:
  - meta: log_type
    value: mailscanner_blacklist
  - meta: source_ip
    expression: evt.Parsed.source_ip
  - parsed: source_ip
    expression: evt.Parsed.source_ip
  - parsed: spam_reason
    expression: evt.Parsed.spam_reason
  - parsed: rawmessage
expression: evt.Line.Rawname: cbrandlehner/mailscanner-spam
description: Parse MailScanner spam logs
onsuccess: next_stage
filter: "evt.Parsed.program == 'MailScanner'"
grok:
pattern: 'Message %{NOTSPACE:message_id} from %{IP:source_ip} \(%{EMAILADDRESS:from_email}\) to %{NOTSPACE:to_domain} is spam.*(score|Wertung)=%{NUMBER:spam_score}'
apply_on: message
statics:
- meta: log_type
value: mailscanner_spam
- meta: source_ip
expression: evt.Parsed.source_ip
- parsed: source_ip
expression: evt.Parsed.source_ip
- parsed: spam_score
expression: float(evt.Parsed.spam_score)
- parsed: rawmessage
expression: evt.Line.Rawname: cbrandlehner/mailscanner-blacklisted
description: Detects MailScanner logs where a message is marked as spam due to blacklisting
type: trigger
filter: "evt.Meta.log_type == 'mailscanner_blacklist' && evt.Parsed.spam_reason == 'blacklisted'"
groupby: evt.Parsed.source_ip
blackhole: 5m
labels:
type: spam
remediation: true
behavior: "smtp:spam"
spoofable: 0
confidence: 2
label: "MailScanner detected an SMTP message from an blacklisted sender"
service: smtpname: cbrandlehner/mailscanner-highscore-spam
description: Detects spam messages in MailScanner logs with score > 20.0
type: leaky
filter: "evt.Meta.log_type == 'mailscanner_spam' && float(evt.Parsed.spam_score) > 20.0"
groupby: evt.Parsed.source_ip
leakspeed: 10s
capacity: 1
blackhole: 5m
labels:
type: spam
remediation: true
behavior: "smtp:spam"
spoofable: 0
confidence: 1
label: "MailScanner classifed an SMTP email as SPAM with a spam_score higher 20"
service: smtpMeine Vorgehensweise:
CrowdSec ist ein mächtiges Werkzeug für die Absicherung von Mail-Infrastrukturen — auf der E.F.A. liefert es sofort Mehrwert für viele Standarddienste. Für spezielle Tools wie MailScanner lohnt sich jedoch die Erstellung eigener Parser und Szenarios: so kannst du präzise Signale erzeugen und die False-Positive-Rate niedrig halten.
Den vollständigen Parser, die Szenarien, die Collection und meine Test-Scenarios habe ich als Pull Request zur Diskussion auf GitHub veröffentlicht: PR #1500 im CrowdSec Hub.
IT WELT-Clip: Zwei-Faktor-Authentifizierung und Techniker-Prozesse26.09.2024Am 26. September 2024 hat IT WELT (Computerwelt, ITW Verlag) einen Clip von einer Minute und 14 Sekunden veröffentlicht. Ich spreche darin über Zwei-Faktor-Authentifizierung und über die Regeln, nach denen Techniker an Kundensystemen arbeiten. Das hier ist die Kurzfassung, nicht ein Wortprotokoll.
Der Clip liegt bei LinkedIn: IT WELT, Sicherheit und Zwei-Faktor-Authentifizierung.
Wer heute noch keine Zwei-Faktor-Authentifizierung verwendet, ist in allergrößter Gefahr. Damit das kein Problem wäre, müsste man sich vom Netz komplett trennen.
Die bekannten Regeln muss man als Prozess durchsetzen:
Vieles, was nach einzelner Technik aussieht, ist eine Frage der Abläufe.
Für einen IT-Dienstleister kommt eine zweite Gefahr dazu. Ein Gerät, mit dem sich Techniker gleichzeitig per VPN auf viele Kundensysteme verbinden, ist eine Brücke. Der Angriff muss nicht beim Dienstleister beginnen. Es reicht, wenn ein Kundensystem auf einem anderen Weg befallen ist. Über die Admin-Geräte kann sich das dann auf die anderen Kundensysteme ausbreiten. Das wäre der Super-GAU eines IT-Dienstleisters.
Damit das nicht passiert, braucht es klare Prozesse und Regeln, wie Techniker arbeiten.
Veröffentlicht am 26. September 2024 von IT WELT. Der LinkedIn-Beitrag trägt die Stichworte Sicherheit, Zwei-Faktor-Authentifizierung, Axians und Itwelt.
Dieselbe Linie zur Zwei-Faktor-Authentifizierung steht in der IT-WELT-Printausgabe 10/2024. Der Roundtable "Volle Cloud voraus" fand bei Axians statt. Dabei waren Christof Baumgartner (ITWelt.at), Simone Frömming (Nutanix), Rainer Schneemayer (Timewarp) und ich. Der Bericht: Volle Cloud voraus.
Capgemini sieht Unternehmen aktuell bei rund 60 Prozent ihrer IT-Services aus eigener oder Anbieter-Cloud, bis 2029 bei nahezu 84 Prozent. Der heimische Markt ist zweigeteilt. Manche betreiben vor Ort kaum noch datenspeichernde Systeme, andere haben mit Cloud noch nichts zu tun. Das Hochwasser in Österreich hat das Risiko einer rein lokalen Infrastruktur sichtbar gemacht. Frömming versteht unter Cloud oft Software as a Service. Bei der Infrastruktur sind viele nur teilweise migriert, und wer schnell wechseln will, scheitert oft am Personal. Ihre Formel dafür: volle Cloud voraus. Schneemayer sieht die Zukunft in der Multicloud. Kaum jemand setzt zu 100 Prozent auf einen Anbieter. Die Schwierigkeit ist, das in eine Strategie zu bringen und die Dienste so zu verteilen, dass das Risiko tragbar bleibt.
Der Anlass für den Wechsel ist oft das Lebensende der Hardware oder eine Vorschrift wie NIS2 und DORA. Wer schon weiß, was er will, baut Anwendungen cloudfähig, mit Kubernetes, Containern und dynamischem Scaling. Für den ersten Schritt ist oft eine 1:1-Kopie sinnvoll, wenn die Software noch nicht für die Cloud gebaut ist, aber mit einer Vorstellung, was danach kommt. Kostendruck schiebt zuerst die Anwendungen, die sich heben und verschieben lassen. Wer vor allem agiler werden will, schaut auf Analytics.
Latenz ist eine physikalische Größe. Latenzempfindliche Anwendungen brauchen von Anfang an den passenden Dienst. Der Betrieb darf während der Migration nicht stehen bleiben. Das braucht Planung, Projektmanagement und Leute, die das können.
Ob die Nutzung gelungen ist, sieht das Geschäft an anderen Stellen als die IT: wie schnell eine Integration aus dem Homeoffice kommt, ob der Prozess effizienter ist. Für die IT-Mitarbeiter ändert sich die Administration der Plattformen, und das stößt auf Widerstand.
Beim Thema Sicherheit, und damit beim Clip oben, sind physische Sicherheit und IT-Sicherheit zweierlei. IT-Sicherheit meint Identitätsdiebstahl und unbefugten Zugriff. Sicherheit ist ein Prozess. Ein Windows-Server in der Cloud ist genauso angreifbar wie einer im eigenen Rechenzentrum. Administrator-Konten müssen besonders gesichert sein. Zwei-Faktor-Authentifizierung ist dafür unverzichtbar. Passwörter werden nicht weitergegeben, gemeinsame Konten gibt es nicht. Schneemayer ergänzt, dass die Angriffswege vor Ort und in der Cloud fast dieselben sind, die Komplexität bei den großen Hyperscalern aber steigt. NIS2 und DORA zwingen dazu, Schwachstellen, Bedrohungen und möglichen Schaden zu benennen. Frömming betont die Schulung: auch eine sauber konfigurierte Software hilft nicht, wenn jemand die Phishing-Mail öffnet. Schneemayer nennt Disaster Recovery as a Service für den Fall, dass der Cloud-Anbieter ausfällt. Viele im Mittelstand wollen kein zweites eigenes Rechenzentrum und müssen festlegen, wie viel Datenverlust und wie lange Ausfall sie tragen.
Bei künstlicher Intelligenz war sich die Runde einig, dass sie bleibt. Bei Nutanix ist ein allgemeines Werkzeug wie ChatGPT verboten, weil die Antworten zu allgemein sind. Für eigene Inhalte braucht es große Sprachmodelle, und die Daten liegen dann in der Cloud, mit denselben Fragen zu Sicherheit und Wiederherstellung. Ich setze im Unternehmen den Microsoft Copiloten ein. Die Rechnung ging nicht um eine halbe Stunde im Monat, sondern eher um 30 Minuten am Tag: Kundendaten aufnehmen, einfache Fragen beantworten, Menschen für das Schwierigere frei machen. Schneemayer sieht Nachfrage nach GPU-Diensten zum Trainieren solcher Modelle, auch aus den USA. Ergebnisse halluzinieren noch und müssen geprüft werden. Der Preis ist Energie und Abwärme. Nachhaltigkeit wird damit zur eigentlichen Frage.


